

CPU重回C位:智能体AI重写数据中心算力标尺
很长一段时间里,业界衡量AI基础设施的“尺子”只有词元(Token)这一组刻度:每秒Token数、每瓦Token数、每美元Token数,这三个数字支撑起了大模型时代几乎全部的性能叙事。然而,当AI开始从“对话生成”走向“智能体执行”,这把“标尺”开始渐渐失准。
根据美国风险投资机构a16z援引的OpenRouter数据,自2026年2月以来,智能体AI的Token使用量增长了约14倍。但比数量更关键的,是性质的变化——Token不再是任务的终点,而是智能体检索上下文、调用工具、执行代码、校验结果的中间产物。
“我们不仅要从Token的角度评估性能,还要从智能体及其所执行任务的角度来评估性能。”Arm云AI解决方案架构总监Ravi Malhotra在日前的一场媒体采访活动上如是说。
围绕这一转变,Arm近期发布了面向智能体AI的CPU性能评估白皮书,并获得富士通、Meta与OpenAI的支持,独立分析机构Signal65亦基于该方法论完成了第三方验证。一次评估标准的更迭,背后折射的正是CPU在AI数据中心中角色的重新定位。
智能体成为“虚拟用户”,CPU重回C位
要理解评估标准为何必须改变,先要看清楚“智能体AI对数据中心做了什么”。
在白皮书中,智能体被描述成为拥有持久计算环境的“虚拟用户”,可以保持状态、检索上下文、调用工具与服务,并持续评估执行结果,直至任务完成。当数百万乃至数十亿个这样的“用户”全天候运转时,计算、内存、存储与输入/输出(I/O)都必须在高并发下具备持续支撑的能力。这不仅对CPU提出了新的要求,也意味着业界需要建立新的评估标准,以测评系统处理智能体实际完成工作负载的能力。
大模型时代,CPU更多是加速器身边的“配角”;而在智能体时代,Arm将其关键任务分为三类:一是将已生成的Token转化为行动——构建、编译、测试代码,访问Web服务器与数据库,这些动作消耗大量CPU周期;二是服务于Token生成本身——作为AI头节点(head node)负责作业调度、数据准备与传输,把KV Cache与向量数据库安放于内存和存储之中,并尽快喂给加速器;三是编排与隔离——将Token生成与行动执行串联为端到端流程,并通过沙箱为每个智能体提供隔离的执行环境。
“如果CPU不够快,更昂贵的GPU就会处于闲置状态,这是没有人希望看到的结果。”在Malhotra看来,CPU的速度,决定了昂贵加速器的利用率。
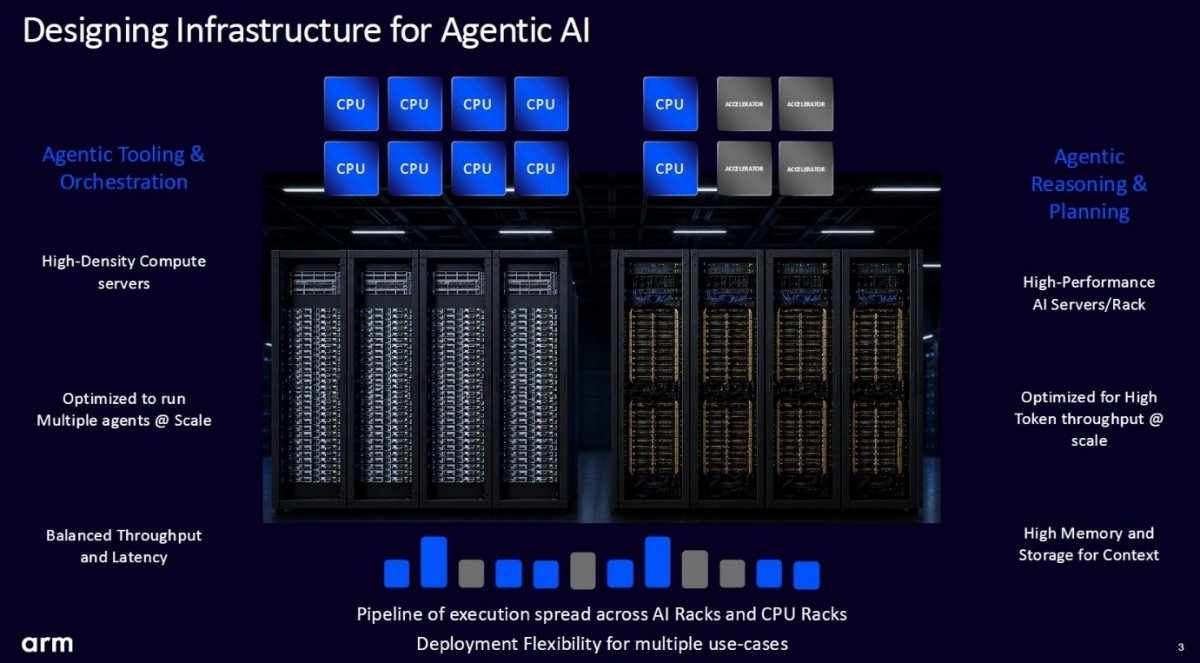
尤其值得注意的是,智能体AI并非替代现有云原生工作负载,而是在其上叠加放大。简单而言,就是智能体发出的每一次搜索、服务调用、代码执行与数据请求,都会转化为底层基础设施的任务。Claude Code、阿里巴巴Qoder、Meta Muse等前沿应用的涌现,印证着这种叠加效应正在从概念走向部署。
与此同时,随着智能体获得更多工具与数据权限,运行时隔离与安全的要求水涨船高,DPU等基础设施处理器开始承担网络、存储、策略执行、遥测与隔离的独立控制平面。数据中心的计算图景,正在围绕智能体被重新绘制。
旧标尺为何失准?
那么,传统基准测试为何不再适用?Malhotra的看法是,其根源在于智能体工作负载的形态,与传统云负载存在本质差异。
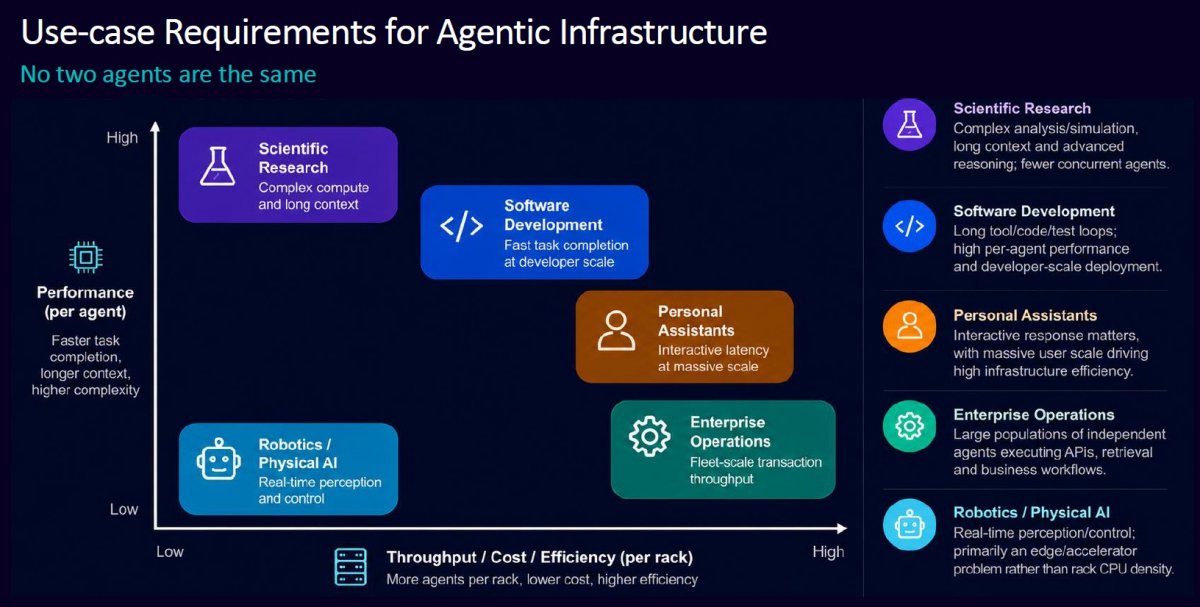
一方面,不同智能体用例对CPU的诉求截然不同。Arm将当前活跃的智能体应用归纳为五类原型:软件工程、企业自动化、科学研究(如金融分析)、个人助理与机器人技术。软件工程智能体的编译与测试耗时长、单智能体性能至关重要;企业客服智能体的单次操作可能只是一次网页或数据库访问,单实例要求不高,但海量的操作数量对并发与吞吐提出极致要求。“没有两个智能体是完全一样的。”Malhotra说,这意味着单一分数很难覆盖全部场景。
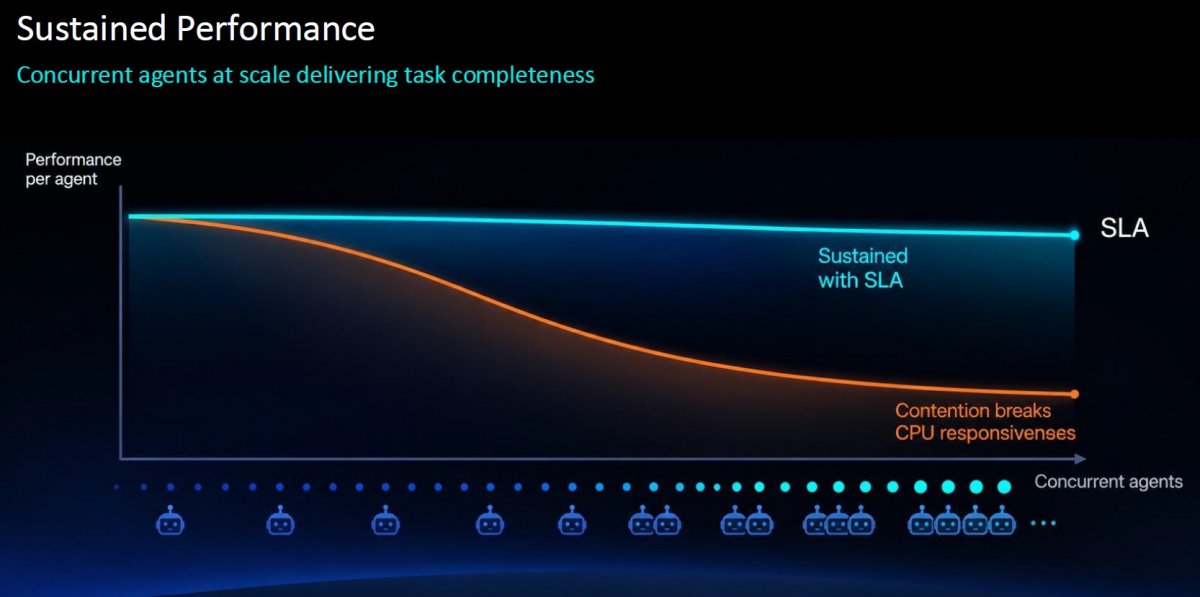
另一方面,智能体任务长时运行、并发敏感,使“持续性能”成为焦点。若吞吐量随资源利用率上升而下降,更多的理论算力并不意味着能完成更多任务。更进一步的约束来自数据中心的物理现实——功耗、散热与机柜空间都有固定的上限,运营商最终关心的,是“在这些限制内能持续完成多少有效工作?”而这正是评估视角必须从单芯片上移到机架的原因。
“客户在数据中心里部署和使用的是整个机架,而不仅仅是单颗CPU。”Malhotra解释说,“芯片VS芯片”的对比无法反映能效、内存利用效率、服务器成本,以及单机架能容纳多少台服务器的差异,一份完整的性能评估还需要在吞吐量与SLA(服务等级协议)之间寻找新的平衡。
例如对Terminal-Bench、SWE-bench这类软件开发负载来说,每核心运行一到两个智能体可能已是上限,再增加并发便无法满足SLA。因此,并发与响应质量之间的取舍,成为评估中的新变量。
Arm的解法:组件基准与端到端智能体基准并行
针对以上出现的种种新问题,Arm在白皮书中明确了评估三原则:具有代表性的智能体应用场景、可重复的CPU性能测试方法、端到端的结果验证。富士通、Meta与OpenAI均对这一框架表示支持。
具体而言,该方法论分为两层。第一层是组件级基准测试。即单独测试Web服务器、数据库、模型服务等组件的开销,排除模型推理与网络等变量干扰,以精确刻画CPU自身的能力。
这一过程中,这些组件基准和智能体基准对CPU进行了不同面向的测试评估。例如,工具调用类组件(如Web服务nginx、数据库MySQL)侧重IPC、I/O与并发;编排侧重CPU并发与利用率;而在推理与规划环节中,CPU充当头节点,涉及向量数据库Milvus与模型服务框架vLLM等,重点考察单线程性能、分支预测、缓存以及内存延迟与带宽。
但组件测试只能回答“每个部件有多强”,却无法反映这些部件在智能体工作流中如何连接与协同——这正是方法论第二层基准的价值所在。据介绍,第二层是端到端智能体基准测试,以SWE-bench与Terminal-Bench等新兴基准为参照,考察真实智能体工作流的可扩展性与并发性,并验证组件层的改进能否转化为更好的任务完成效果。
沙箱开销也被纳入评估视野。出于数据与隐私考虑,智能体普遍需要在隔离环境中运行,而创建沙箱的时间成本即便以毫秒计,在规模化之下也会放大为可观的系统开销。Arm的测试覆盖了冷创建、热创建,以及多容器在同一物理核上并行运行的超额订阅等场景,并对Docker、Firecracker、gVisor等主流沙箱技术进行了对比。
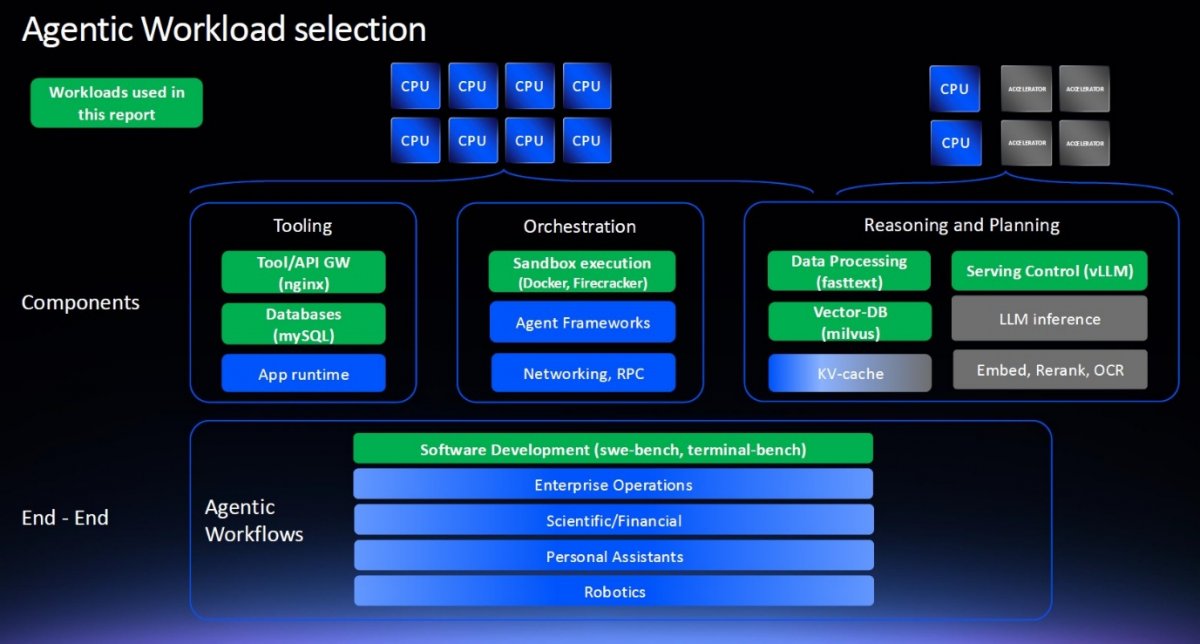
Malhotra表示,Arm提出的是一套方法论,而非正式的行业标准或单一基准测试,也不建议对五类用例原型赋予权重。“我们建议用户先判断自己的用例属于哪一类原型,再据此选择相应的端到端智能体基准和组件进行评估。”在智能体基准“几乎每周或每隔一周就会出现一个新的”的行业节奏下,让方法论保留演进空间,或许比急于定标更务实。
1.99倍机架级性能从何而来?
方法论最终要接受实测数据与机架级模型结果的检验。
独立分析机构Signal65基于该方法论发布独立验证报告称,对比Arm AGI CPU与第五代AMD EPYC Turin在工具调用、编排、推理与规划等工作负载上的表现,两个平台采用相同的基准测试脚本,并基于实测的服务器级数据构建机架级性能模型。
结果显示,在七项工作负载中,Arm AGI CPU平均实现了EPYC 9755约1.99倍的机架级性能。场景分类来看,工具调用场景为1.7倍,智能体工作流与任务编排场景为2倍,推理与规划场景为2.2倍。相较EPYC 9965,Arm AGI CPU最多可将沙箱创建时延降低45%。
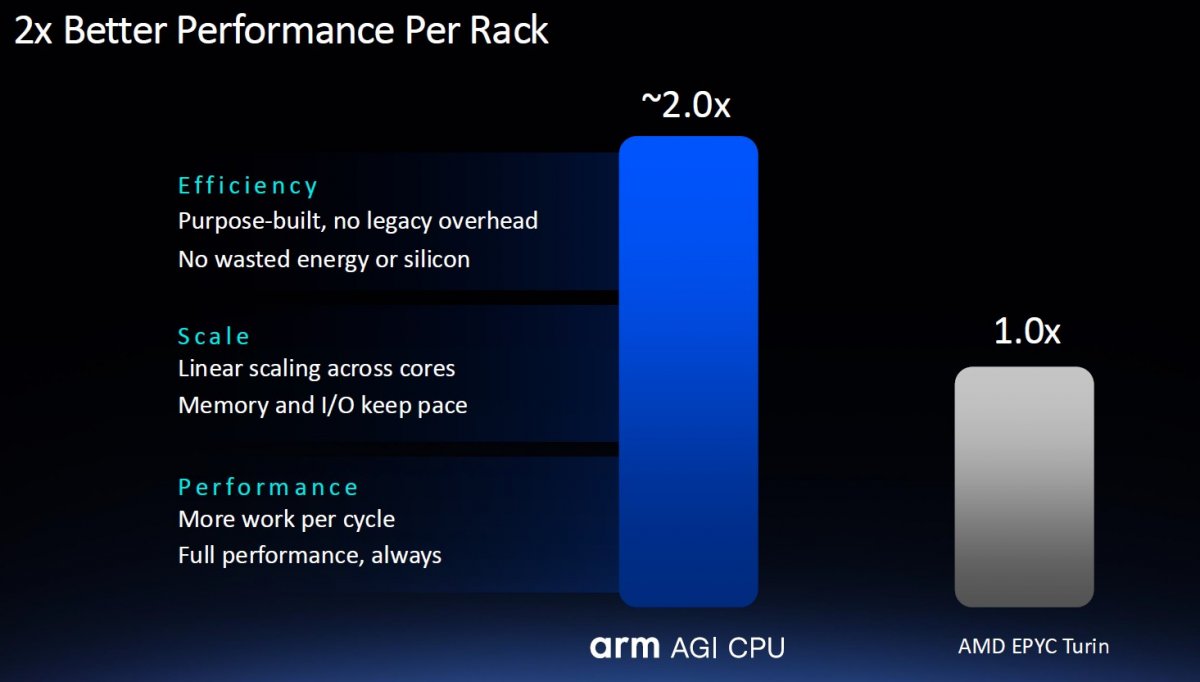
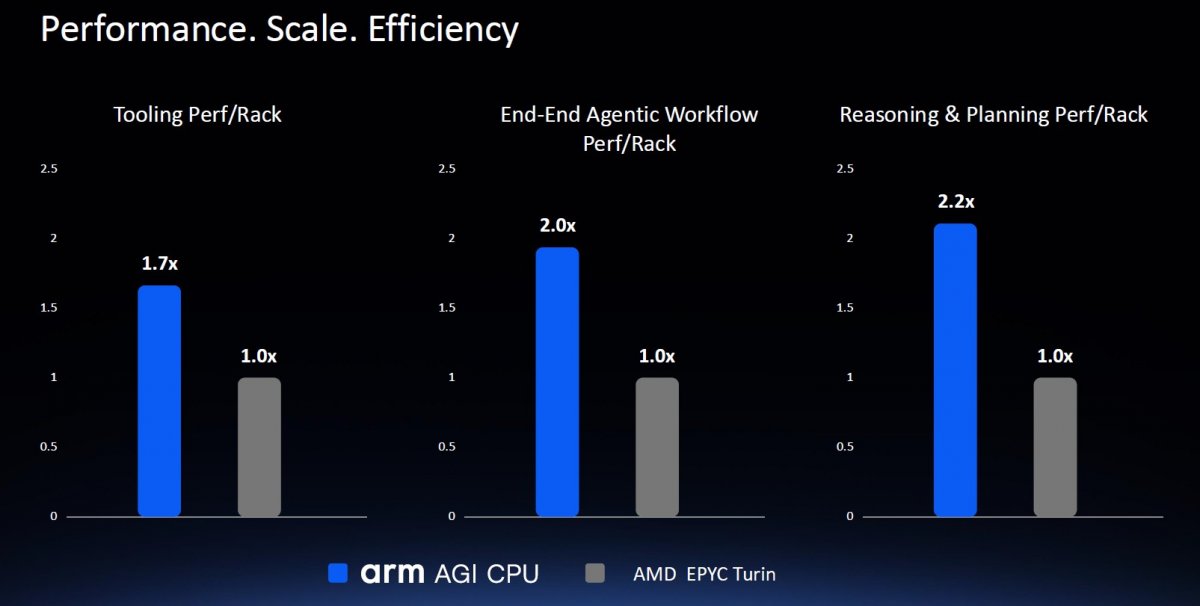
Signal65方面在报告中指出,Arm AGI CPU在每核以及CPU SoC层面的性能平均领先约20%,其余的增量来自效率与可扩展性:每核心功耗更低,意味着相同机架功耗预算下可以部署更多核心。也就是说,每核性能、每颗CPU性能与每机架核心数量三者相结合,才最终堆叠出机架级的倍数优势。
这印证了Arm CPU一贯的设计哲学——把能效作为设计的核心约束,而非事后取舍。从Neoverse N1到V3(Arm AGI CPU 的核心),Arm通过与超大规模云服务商合作,围绕SQL数据库、缓存、推理等真实云工作负载持续调优微架构;而AGI CPU则以高核心密度、每核心内存配置与高带宽I/O,进一步强化对智能体负载持续运行的支撑。
沙箱数据同样意义重大。在企业运营这类高并发场景中,每个核心上运行多个智能体,更低的隔离开销意味着单位时间内能处理更多客户支持工单,单任务成本随之下降。性能优势只有落到这样的具体运营环节中,才能转化为成本优势,这正是机架级评估的现实意义。
从方法论到产品,一场仍在演进的评估叙事
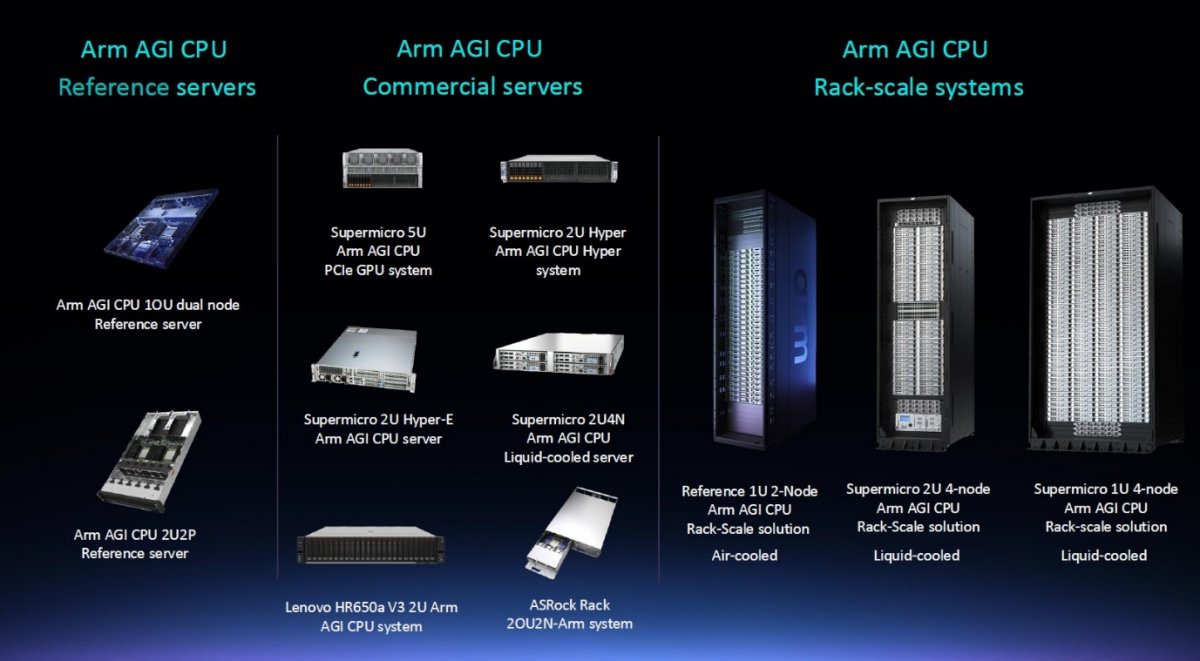
在产品层面,Arm设计了AGI CPU 1OU双节点与2U2P两款服务器参考设计,超微电脑(Supermicro)、联想与华擎科技(ASRock)提供不同尺寸与配置的量产平台和商用服务器;机架层面则覆盖风冷与液冷方案,包括19英寸与Open Rack双宽两种规格。在近期举行的开放计算全球峰会(OCP Global Summit)上,Arm正推进向OCP贡献AGI CPU服务器参考设计,Meta的Yosemite YV5机架级设计也将AGI CPU纳入其中。
测评方法论获得业界重量级玩家的背书,同样是生态叙事的一部分。富士通高级副总裁、先进计算开发事业部负责人Toshio Yoshida表示,在开发下一代Arm架构CPU FUJITSU-MONAKA的过程中,深感透明、可重复且具有代表性的测评体系之重要。
而OpenAI全球前沿部署工程负责人Colin Jarvis则指出,随着AI系统从生成内容发展为通过推理、使用工具与软件环境交互来完成复杂任务,围绕代表性基准测试的行业协作,对刻画新兴工作负载、优化整个AI系统性能至关重要。
但也要看到,智能体AI的评估标准远未尘埃落定。Arm、AMD、Intel各有自己的智能体CPU基准,负载原型、部署拓扑与聚合口径各不相同,智能体基准本身也仍在快速演进。正如Malhotra所言,这项工作“绝不会就此止步”,但对行业而言,一个可用方法论的出现,或许比一个统一标准的到来更有价值——至少从今天起,讨论智能体时代的CPU性能时,业界有了一套指向真实工作负载的共同语言。
